本机测量结果
以下图表来自 UDP 性能报告。
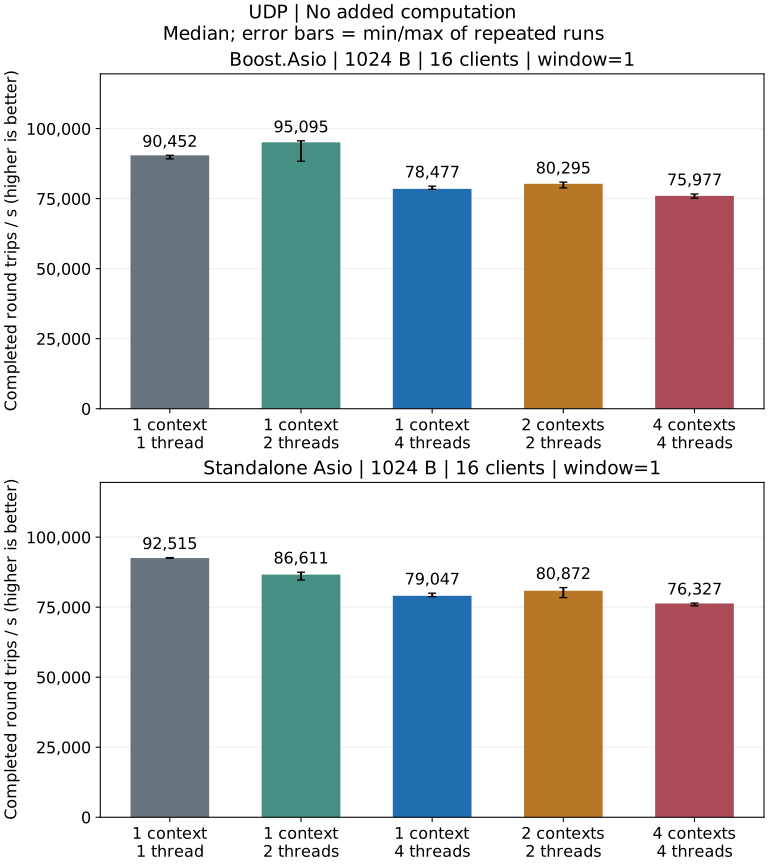
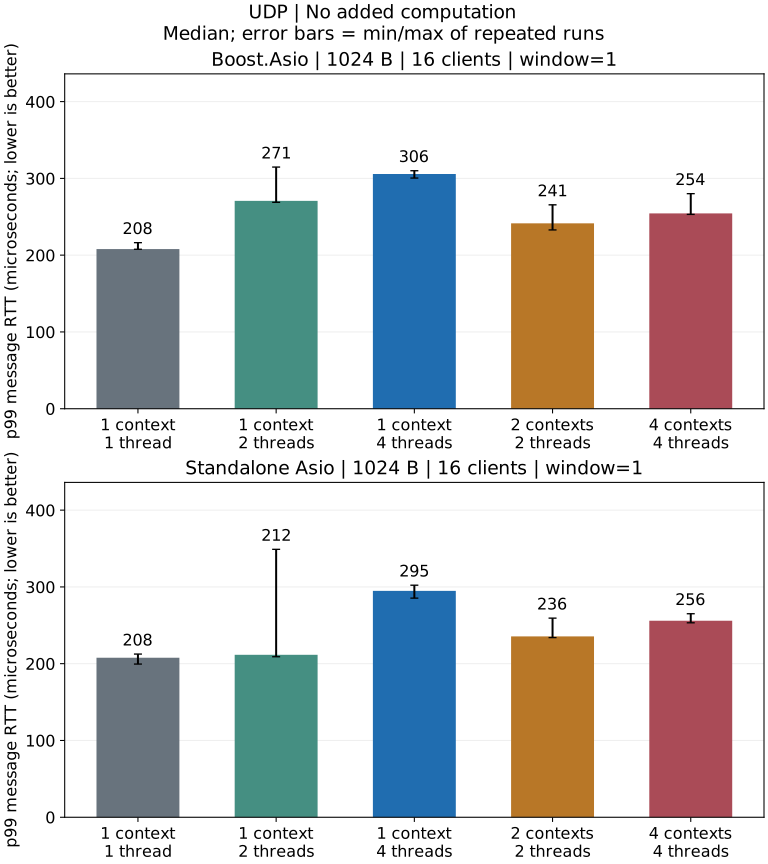
Release 本机回环测试:1024 字节数据报、16 个客户端、窗口 1,无额外业务计算。
本机结论
- Standalone 以 1 个 io_context、1 个线程的吞吐量中位数最高。Boost 双线程略高,但 p99 和 CPU 占用也高于单线程。
- 1 个 io_context、4 个线程和 4 个 io_context 各 1 个线程的吞吐量中位数均低于 1 个 io_context、1 个线程。服务端使用单个 socket 和串行接收通道,增加线程无法并行执行其接收回调。
构建与执行
在仓库根目录使用 Release 构建。测试 Boost 时,将 Asio 头文件路径参数替换为 -DARKNET_USE_BOOST_ASIO=ON,保持其他条件一致。
命令采用单配置 generator。使用 Visual Studio 时,在构建命令中加入 --config Release,并运行 benchmarks/Release/ 下的可执行文件。Windows 可执行文件带有 .exe 后缀。
cmake -S . -B build-perf -DCMAKE_BUILD_TYPE=Release \
  -DARKNET_BUILD_BENCHMARKS=ON -DARKNET_ENABLE_SSL=OFF \
  -DARKNET_USE_BOOST_ASIO=OFF -DARKNET_ASIO_INCLUDE_DIR=/path/to/asio/include
cmake --build build-perf --target arknet_loopback_benchmark --parallel 3
build-perf/benchmarks/arknet_loopback_benchmark \
  --protocol udp --payload 1024 --clients 16 --window 1 \
  --io-model shared --io-threads 1 --work 0 --warmup 0.25 --seconds 1
这个配置使用 1024 字节数据报、16 个客户端、1 个 context 和 1 个线程,每客户端
保留一条在途消息,并向标准输出写入 JSON。每组配置用独立进程重复三次。
将 --io-threads 改为 2 或 4 可比较共享 context,使用
--io-model sharded --io-threads 4 可比较 4 个 context 各 1 个线程。
--work 10000 表示每次回显增加 10,000 次确定性运算,0 表示无额外业务计算。
完整 shell 矩阵见测试。
基准为 UDP 端点请求 65536 字节 socket 发送缓冲区和 4 MiB 接收缓冲区。JSON 记录操作系统实际值,包括客户端的最小和最大值;系统可能限制请求大小。这只是基准配置,不改变 arknet 的 socket 默认值。--udp-server-receive-buffer BYTES 可单独改变服务端接收缓冲;应用配置见缓冲区与流量控制。
较大窗口探测
显式运行较大窗口,观察更高发送负载下的排队或丢失:
build-perf/benchmarks/arknet_loopback_benchmark \
  --protocol udp --payload 1024 --clients 16 --window 16 \
  --io-model shared --io-threads 4 --work 0 --warmup 1 --seconds 3
报文大小与 MTU
| 普通 UDP 包体 | IPv4 | IPv6 |
|---|---|---|
| 协议最大值 | 65,507 字节 | 65,527 字节 |
| MTU 1,500 时的免分片上限 | 1,472 字节 | 1,452 字节 |
| MTU 16,384 时的数学预算 | 16,356 字节 | 16,336 字节 |
这些预算假定没有 IP options 或扩展头,且不包含 IPv6 jumbogram。 IPv4 和 IPv6 的 IP 头不同,不能混用这些数值。
IPv4 边界与突发丢包报告使用 16 个客户端、 1 个 context、1 个线程,每种依赖方案 36 次通过、18 次失败。 65,507 字节在窗口 1 下通过;16 KiB 在窗口 16 下通过,窗口 64 下每次丢失 767 条回显。 每种依赖方案的接收缓冲溢出计数增加 23,778,而 IPv4 分片和重组计数始终为零, 不能根据本机 MTU 的数学计算断言分片是丢包原因。这些结果未测量 IPv6 丢包或跨主机行为。
IO 模型测量中 UDP 使用窗口 1,TCP 和 WebSocket 使用窗口 16,结果不能直接用于跨协议容量排名;较大窗口发生丢失时,该测量失效。测试未覆盖广播、组播、DTLS 或跨主机网络;RUDP 有独立报告。实际部署仍需验证发送节奏、丢失、乱序和 MTU。