原生 Asio 协程基线
原生 Asio TCP 协程 Release 本机回环测试:1024 字节消息、16 个客户端、窗口 16;延迟为批次 RTT。
无额外业务计算
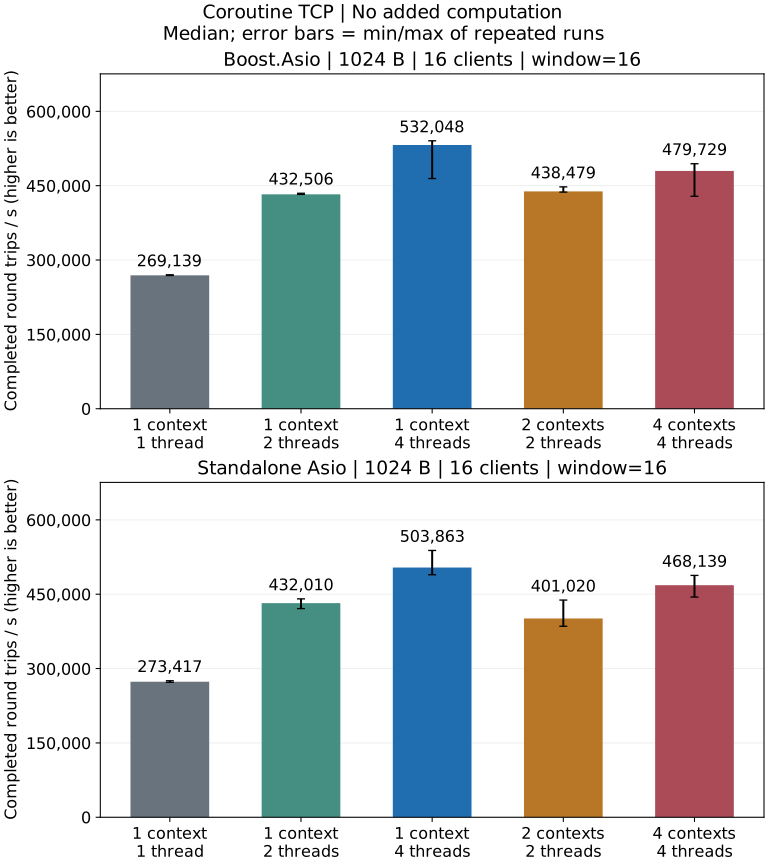
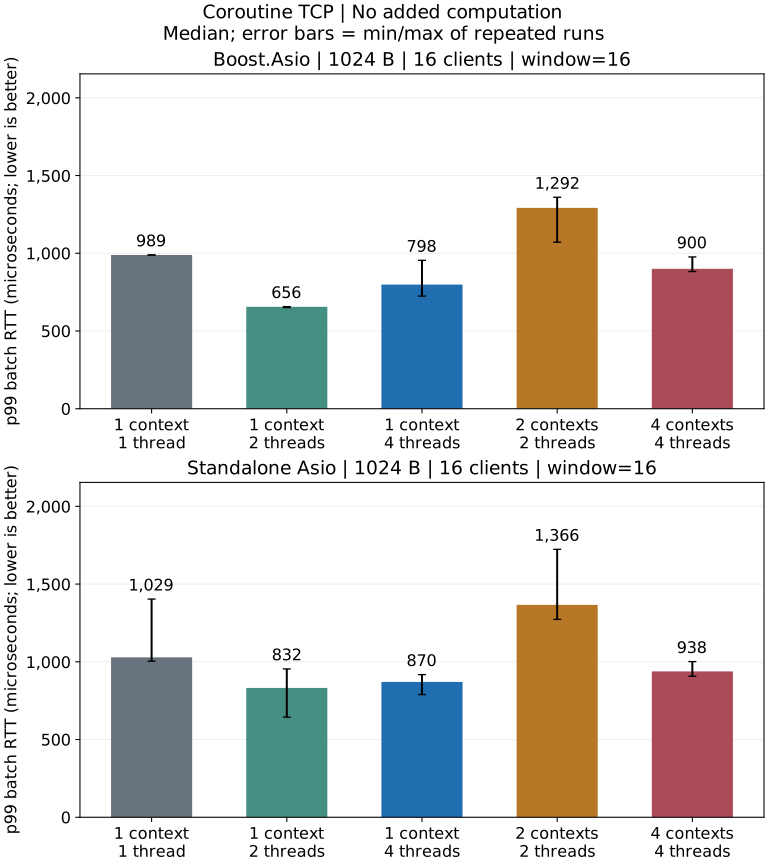
- 两种依赖方案都以 1 个 io_context、4 个线程的吞吐量中位数最高,1 个 io_context、2 个线程的批次 p99 中位数最低。
- Standalone Asio 的 1 个 io_context、2 个线程与 1 个 io_context、4 个线程的批次 p99 运行范围重叠,不能据此确认稳定的尾延迟优势。
每次回显增加 10,000 次确定性运算
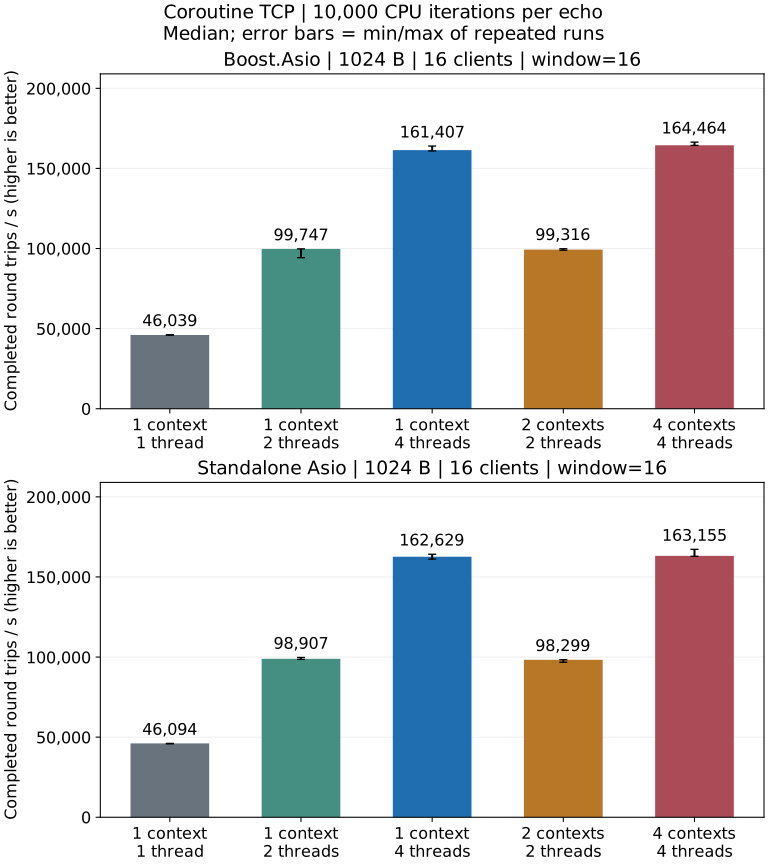
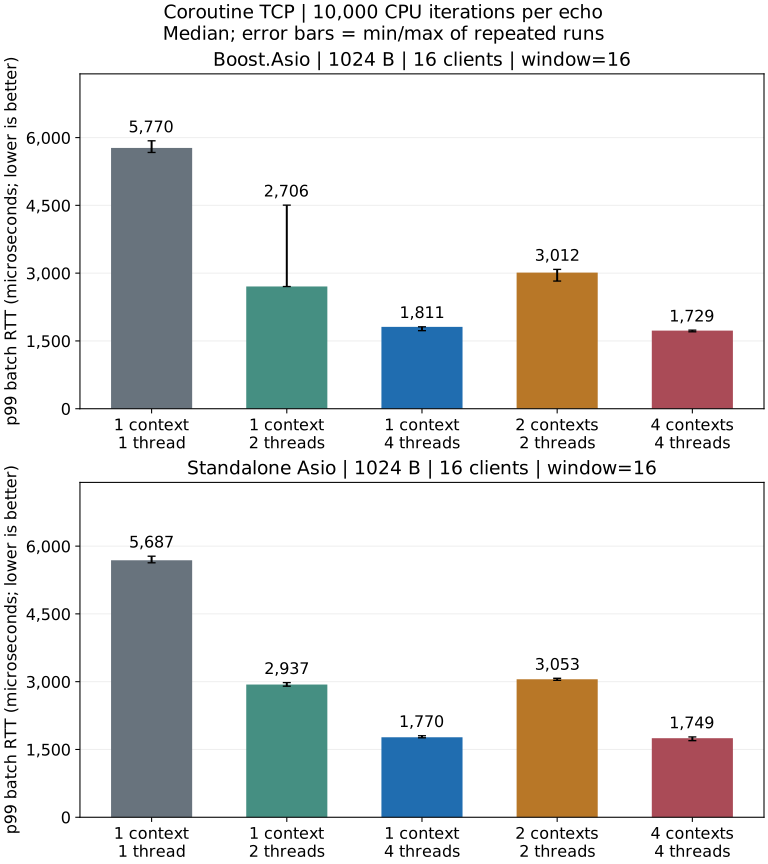
- 两种依赖方案都以 4 个 io_context 各 1 个线程的吞吐量中位数最高、批次 p99 中位数最低。
- 1 个 io_context、4 个线程与 4 个 io_context 各 1 个线程的批次 p99 运行范围在两种依赖方案中均有重叠。
复现比较
benchmarks/loopback.cpp 是 arknet 回调程序,benchmarks/coroutine.cpp 是原生
Asio 回调/协程程序。两者都有独立 main,使用 CMake 编译后直接运行 C++ 可执行文件:
cmake -S . -B build-perf -DCMAKE_BUILD_TYPE=Release \
  -DARKNET_BUILD_BENCHMARKS=ON -DARKNET_ENABLE_SSL=OFF \
  -DARKNET_USE_BOOST_ASIO=OFF -DARKNET_ASIO_INCLUDE_DIR=/path/to/asio/include
cmake --build build-perf --target arknet_coroutine_benchmark --parallel 3
build-perf/benchmarks/arknet_coroutine_benchmark \
  --execution coroutine --protocol tcp --payload 1024 --clients 16 --window 16 \
  --io-model shared --io-threads 4 --work 0 --warmup 0.25 --seconds 1
这个例子使用 1 个 context、4 个线程、1024 字节消息、16 个客户端和窗口 16,
向标准输出写入 JSON。使用 Boost 时,将 Asio 头文件参数替换为
-DARKNET_USE_BOOST_ASIO=ON。使用 Visual Studio 时,加入 --config Release,
并运行 benchmarks/Release/ 下带 .exe 后缀的程序。
--io-model 中的 shared 表示同一 io_context 由多个线程运行,sharded
表示每个线程使用独立 io_context。设置 --io-threads 1 可测试单 context、单线程;
--execution callback 运行匹配的原生回调模式。--work 10000 表示每次回显增加 10,000 次
确定性运算,0 表示无额外业务计算。这是模拟负载,不代表真实解析器或加密算法。
只比较同一测试程序、依赖方案、负载大小、并发配置和计算量下的不同拓扑。
Asio 协程测试程序按固定大小批次发送和接收;--window 大于一时记录批次 RTT。
arknet 回调测试程序持续补充窗口,记录单条消息 RTT。两者的吞吐量和延迟
不能用来断言协程相对回调的加速比。
扩展对比使用同一原生 Asio TCP 程序的回调和协程模式。服务端完整读取一批数据, 逐条执行指定计算后整批回写。窗口为 1 时记录单消息 RTT,更大窗口记录批次 RTT。 见匹配对比。
用独立 C++ 进程重复配置,或使用测试中的维护者 shell 矩阵。
只有批量工具需要 jq、GNU timeout 和 shasum;直接运行 C++ 功能测试和单项基准
不需要这些工具。
原始结果和测试命令见 测试与性能。短时回环测量 不能预测广域网延迟或生产容量。